모델보다 먼저 확인해야 할 것: 이 문제는 단위는 무엇인가
데이터와 문제의 단위에 대해 신경쓰기.
최근 실험을 하다가 모델 구조보다 먼저 확인했어야 하는 질문을 뒤늦게 다시 보게 됐다.
이 라벨은 정확히 어떤 단위에 붙어 있는가?
처음에는 데이터가 많아 보였다. 로그도 많고, 이벤트도 많고, 잘게 나누면 샘플도 꽤 많이 만들 수 있었다. 그래서 자연스럽게 작은 단위의 샘플을 만들고, 그 위에 모델을 얹는 방식으로 생각했다.
그런데 실험을 돌릴수록 이상한 느낌이 들었다. 모델은 복잡해졌고 입력 정보도 많아졌는데, 기대만큼 일반화되지 않았다. 어떤 지표는 좋아 보이는데, 정작 중요한 케이스를 놓치는 일이 반복됐다.
문제는 모델이 충분히 깊지 않아서가 아니었다. 데이터의 단위를 잘못 보고 있었다.
샘플의 단위와 라벨의 단위#
머신러닝 실험에서 우리는 보통 X와 y를 만든다.
X: 모델에 넣을 입력y: 예측하고 싶은 정답
문제는 이 둘이 항상 같은 단위에 자연스럽게 붙어 있지 않다는 점이다.
예를 들어 다음과 같은 데이터가 있다고 해보자.
- 한 사람에게 여러 개의 센서 로그가 있다.
- 한 사용자가 여러 번의 세션을 가진다.
- 한 문서가 여러 문단으로 나뉜다.
- 한 환자에게 여러 장의 이미지가 있다.
- 한 회사에 여러 개의 거래 기록이 있다.
이때 라벨이 어디에 붙어 있는지가 중요하다.
라벨이 문단 단위인지, 문서 단위인지. 이미지 한 장 단위인지, 환자 단위인지. 이벤트 단위인지, 사용자 단위인지. 이걸 명확히 하지 않으면 데이터가 많아 보이는 착시가 생긴다.
문서 하나에 라벨이 붙어 있는데 문단을 여러 개로 쪼갠 뒤, 모든 문단에 같은 문서 라벨을 붙일 수는 있다. 기술적으로는 가능하다. 하지만 그 순간부터 그 문단들은 완전히 독립적인 샘플이 아니다.
환자 한 명에게 이미지가 100장 있다고 해서, 진단 라벨도 100개가 되는 것은 아니다. 진단 라벨은 여전히 환자 1명에게 붙어 있다.
이 차이를 놓치면 모델은 생각보다 쉽게 잘못된 방향으로 간다.
데이터가 많아 보이는 착시#
가장 흔한 착시는 샘플 수가 늘어난 것처럼 보이는 것이다.
원래는 300명의 데이터가 있었는데, 각 사람에게서 20개의 세그먼트를 만들면 6,000개의 샘플이 생긴 것처럼 보인다. 숫자만 보면 훨씬 넉넉해 보인다.
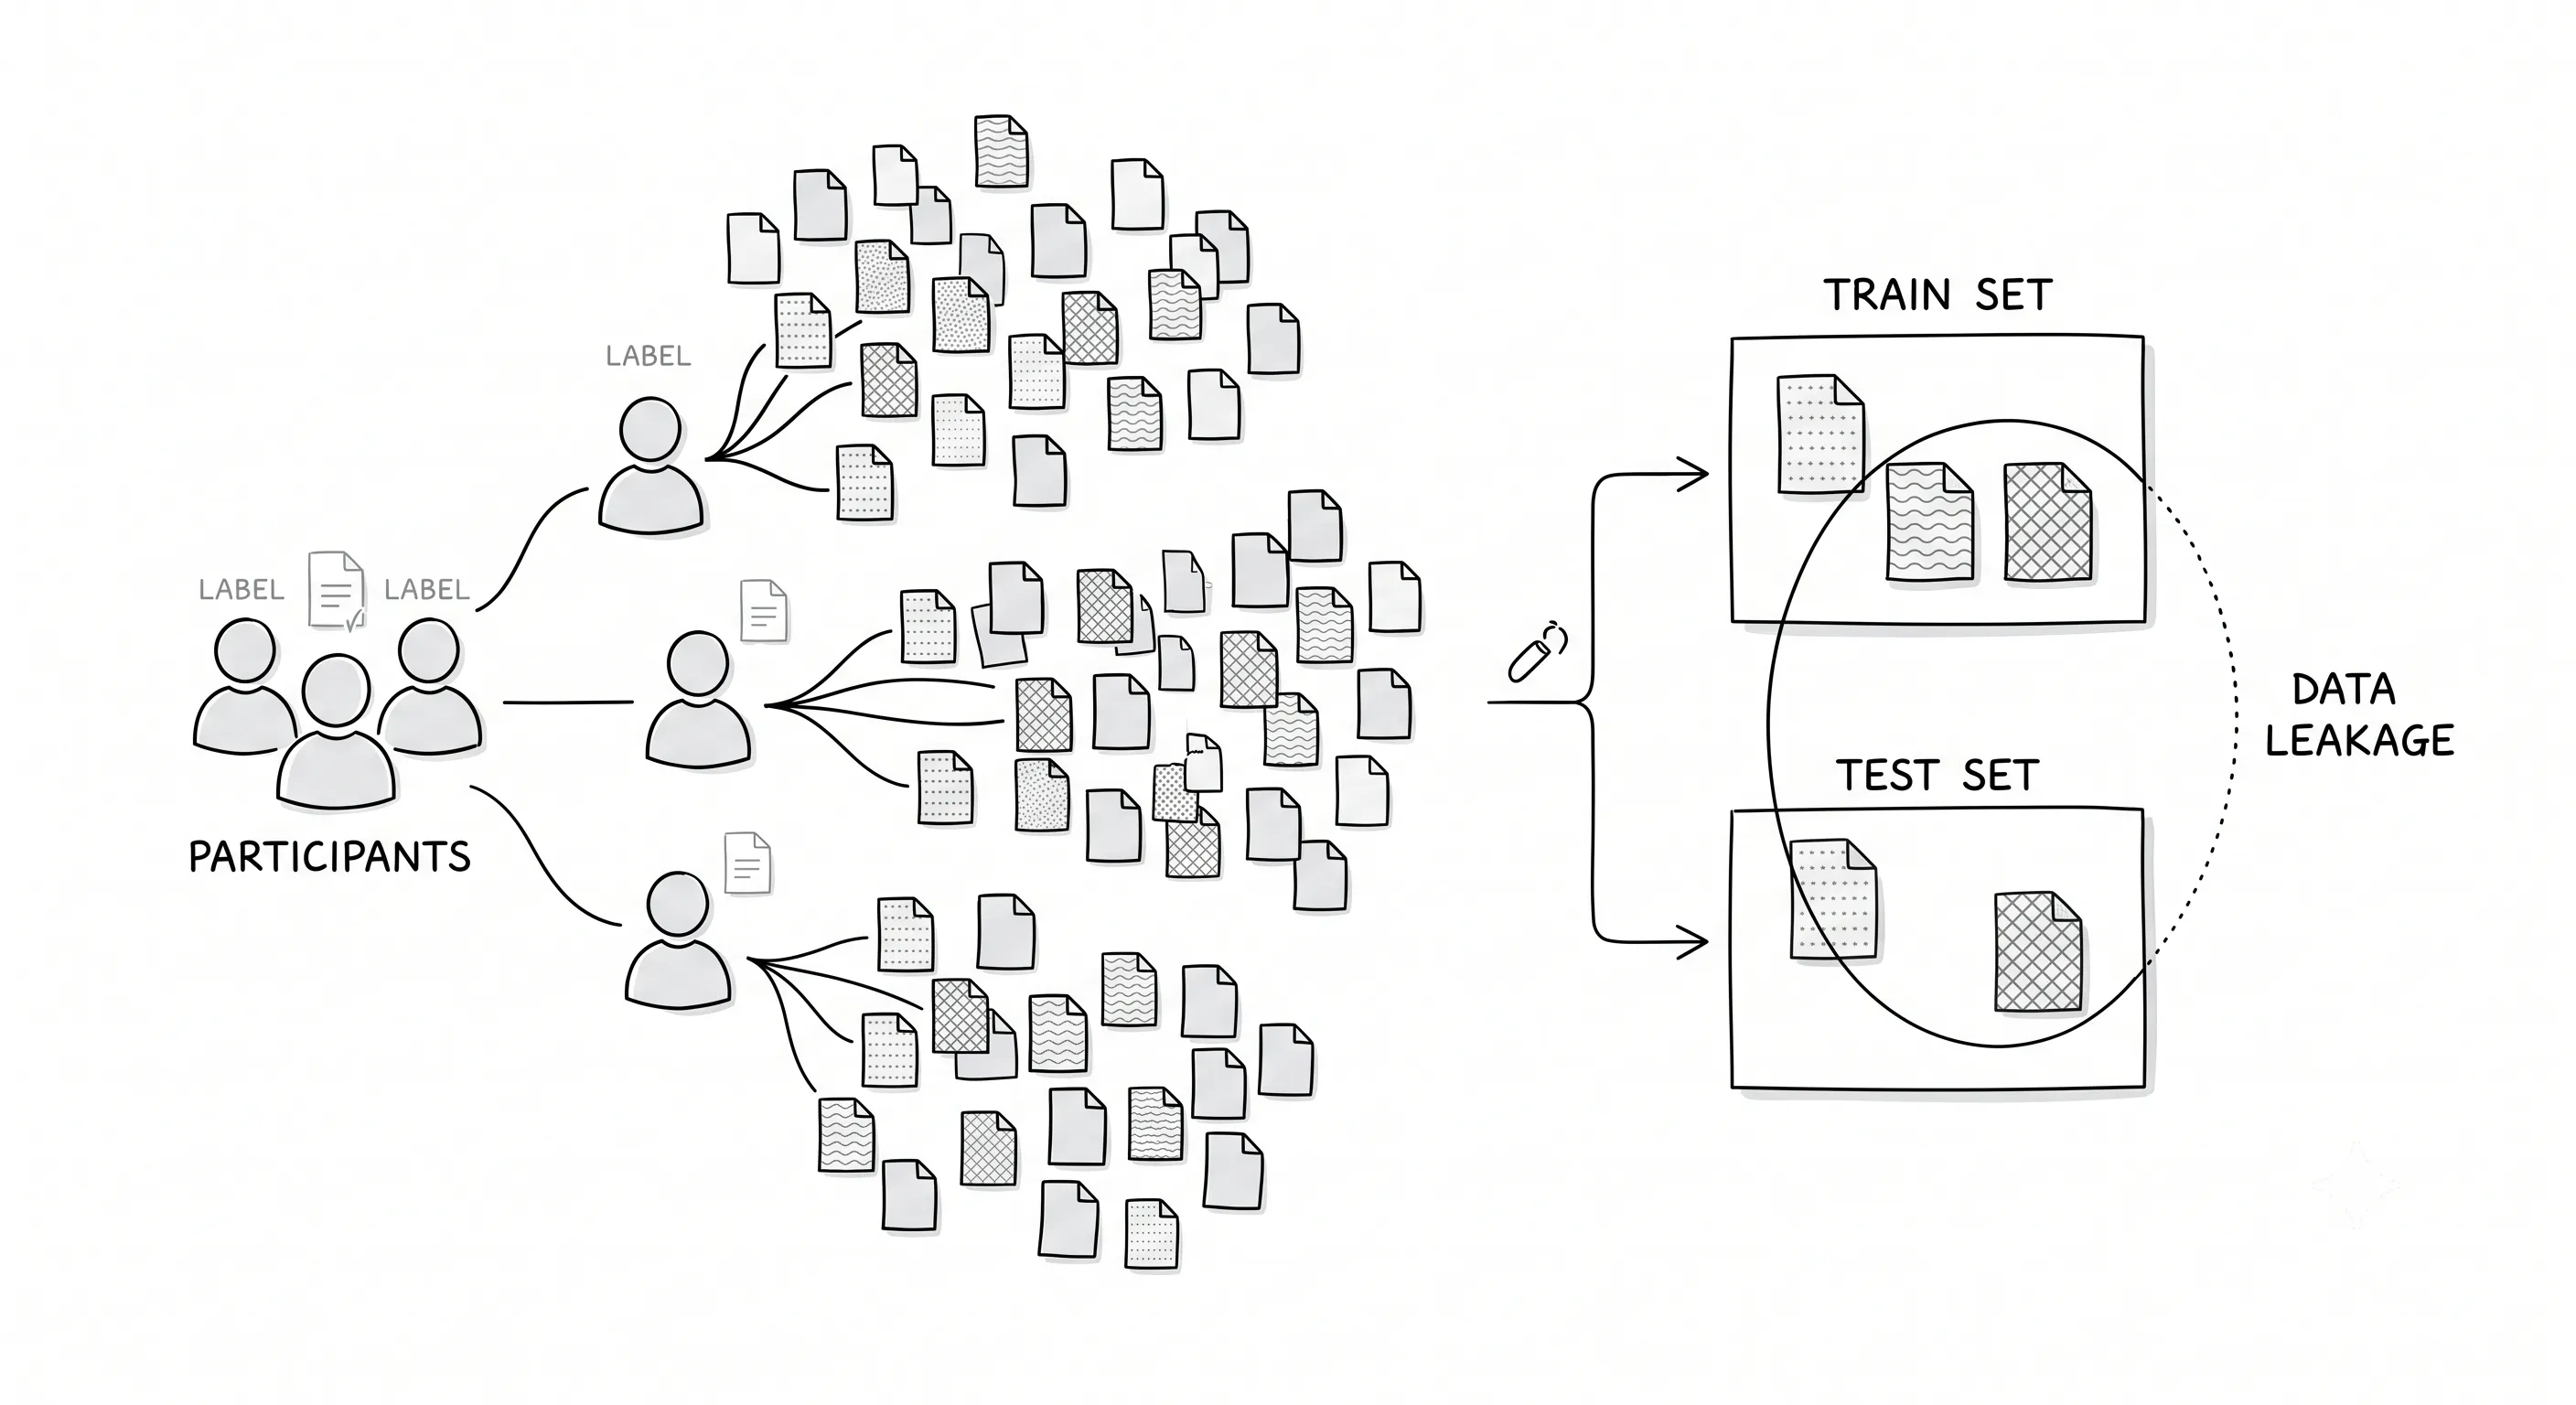 하지만 예측하려는 라벨이 사람 단위라면, 독립적인 라벨은 여전히 300개다. 세그먼트 6,000개는 유용한 입력 조각일 수 있지만, 6,000개의 독립적인 정답이 생긴 것은 아니다.
이걸 무시하면 두 가지 문제가 생긴다.
첫째, 모델이 같은 상위 단위에서 나온 샘플들을 외워버릴 수 있다.
둘째, train/test split이 잘못되면 같은 사람, 같은 문서, 같은 세션에서 나온 조각이 train과 test에 동시에 들어갈 수 있다.
후자는 특히 위험하다. 겉보기 성능은 올라가지만, 실제로는 새로운 사람이나 새로운 문서에 일반화한 것이 아닐 수 있다.
split은 라벨의 단위에 맞춰야 한다#
이 문제를 피하려면 split 기준을 다시 봐야 한다.
작은 샘플 단위로 랜덤 split을 하면 안 되는 경우가 많다. 라벨이 상위 단위에 붙어 있다면, split도 그 상위 단위를 기준으로 해야 한다.
예를 들어:
| 데이터 구조 | 입력 샘플 | 라벨 단위 | 안전한 split 기준 |
|---|---|---|---|
| 문서 분류 | 문단 | 문서 | 문서 |
| 의료 이미지 | 이미지 | 환자 | 환자 |
| 사용자 행동 로그 | 세션/이벤트 | 사용자 | 사용자 |
| 회사 거래 기록 | 거래 | 회사 리스크 | 회사 |
| 센서 로그 | 활동 조각 | 참여자 상태 | 참여자 |
핵심은 간단하다.
test set에 들어간 상위 단위는 train set에 나타나면 안 된다.
문단 분류 실험처럼 보이더라도 실제 라벨이 문서 라벨이라면 문서 단위로 나눠야 한다. 이미지 분류처럼 보이더라도 실제 라벨이 환자 라벨이라면 환자 단위로 나눠야 한다.
이걸 지키면 성능이 낮아질 수 있다. 하지만 그 낮아진 성능이 더 정직한 성능이다.
작은 단위 샘플이 쓸모없다는 뜻은 아니다#
그렇다고 작은 단위의 샘플을 만들면 안 된다는 말은 아니다. 오히려 많은 문제에서 작은 단위의 입력은 꼭 필요하다.
문단은 문서의 내용을 구성한다.
이미지는 환자의 상태를 보여주는 관찰치다.
센서 이벤트는 행동 패턴의 흔적이다.
거래 기록은 회사의 리스크를 설명하는 단서다.
문제는 이 작은 단위에 최종 라벨을 바로 붙여 독립 샘플처럼 다루는 것이다.
더 자연스러운 방식은 작은 단위에서 representation을 만들고, 그것을 라벨이 붙어 있는 단위로 모으는 것이다.
예를 들면:
- 문단 embedding을 만든다.
- 문서 안의 문단 embedding을 aggregate한다.
- 최종 문서 라벨을 예측한다.
또는:
- 이미지별 feature를 만든다.
- 환자별로 여러 이미지 feature를 aggregate한다.
- 최종 환자 라벨을 예측한다.
이런 구조에서는 작은 단위의 정보도 버리지 않고, 라벨의 단위도 존중할 수 있다.
aggregation은 단순한 후처리가 아니다#
처음에는 aggregation을 대충 평균 내는 정도로 생각하기 쉽다. 하지만 실제로는 이 부분이 모델링의 핵심이 되는 경우가 많다.
어떤 문단이 문서 분류에 중요한가.
어떤 이미지가 환자 상태를 가장 잘 보여주는가.
어떤 세션이 사용자의 위험 신호를 담고 있는가.
어떤 이벤트 묶음이 최종 판단에 기여하는가.
이 질문은 단순히 모델 성능의 문제가 아니라 해석 가능성과도 연결된다.
평균 pooling은 모든 조각을 비슷하게 본다. 반면 attention pooling이나 multiple instance learning 계열 접근은 상위 단위 안에서 중요한 조각을 더 크게 반영할 수 있다.
이렇게 보면 모델의 역할도 조금 달라진다. 작은 단위의 모델은 최종 분류기가 아니라 representation learner에 가깝다. 최종 의사결정은 상위 단위에서 일어난다.
이 관점을 받아들이면 복잡한 모델을 어디에 써야 하는지도 더 분명해진다. 무작정 작은 샘플마다 최종 라벨을 맞히게 하는 것이 아니라, 작은 샘플에서 좋은 표현을 만들고 그것을 올바른 단위로 모으는 데 집중하게 된다.
성능이 낮아지는 것은 실패가 아닐 수 있다#
라벨 단위에 맞춰 split을 다시 하고, participant/document/user 단위로 aggregation을 하면 성능이 낮아질 수 있다.
처음에는 실망스럽다. 이전에는 숫자가 더 좋아 보였기 때문이다.
하지만 이때 낮아진 성능은 모델이 나빠졌다는 뜻만은 아니다. 오히려 이전 성능이 과하게 낙관적이었을 가능성을 보여준다.
특히 다음과 같은 상황에서는 더 조심해야 한다.
- 한 상위 단위에서 여러 샘플이 파생된다.
- 파생된 샘플들이 서로 매우 비슷하다.
- 라벨은 파생 샘플이 아니라 상위 단위에 붙어 있다.
- 랜덤 split을 하면 같은 상위 단위의 샘플이 train/test에 섞일 수 있다.
- class imbalance가 커서 accuracy가 쉽게 부풀려진다.
이런 경우에는 좋은 모델을 만드는 일보다 먼저, 좋은 평가 설정을 만드는 일이 중요하다.
What I learned#
모델을 바꾸기 전에, 예측하려는 라벨이 어떤 단위에 존재하는지 먼저 확인해야 한다.
데이터를 잘게 쪼개는 것은 쉽다. 그래프를 만들 수도 있고, sequence를 만들 수도 있고, embedding을 만들 수도 있다. 하지만 라벨의 단위를 바꾸는 것은 다른 문제다.
작은 단위의 샘플이 많아졌다고 해서 독립적인 정답이 많아지는 것은 아니다. 이 차이를 놓치면 모델은 좋아지는 것처럼 보이지만, 실제로는 잘못된 단서에 기대고 있을 수 있다.
앞으로는 실험 시작 전 이 질문부터 던지기를 잊지 말아야겠다..
- 이 라벨은 어디에 붙어 있는가?
- 입력 샘플은 라벨 단위와 같은가?
- split은 어떤 단위로 해야 안전한가?
- 작은 단위의 정보는 어떻게 상위 단위로 모을 것인가?
- 성능표가 정말 새로운 상위 단위에 대한 일반화를 보여주는가?
모델 구조를 고민하는 일은 그 다음이다.
좋은 모델은 좋은 데이터 단위 위에서만 제대로 평가될 수 있다.